Acrobat 데스크톱의 모든 도구 > 스캔 및 OCR에서 처리할 페이지와 문서 언어를 지정해 텍스트 인식을 실행하면 이미지형 스캔 PDF에 선택·검색 가능한 텍스트 레이어가 추가됩니다.
먼저 원본을 복사해 보관하고, 계약서가 한글이면 문서 언어를 한국어로 맞춥니다. OCR 뒤에는 이름 검색, 문장 복사, 이름·날짜·금액 등 5곳의 원문 대조를 모두 통과해야 합니다.
스캔 PDF에서 검색과 복사가 막히는 이유
종이 계약서를 스캔한 PDF가 이미지 데이터로만 저장되면 화면에는 글자가 보여도 이름 검색이나 문장 선택이 되지 않습니다. 이 상태에서는 보이는 문자를 텍스트로 인식하는 OCR 처리가 필요합니다.
먼저 찾기 기능으로 계약서의 고유한 이름을 검색하고, 선택 도구로 문장을 드래그해 보세요. 둘 다 되지 않으면 텍스트 레이어가 없는 이미지형 PDF인지 확인할 수 있습니다.
중요한 계약서에는 바로 작업하지 말고 원본을 보존한 뒤 복사본에서 먼저 시험하세요.
페이지 범위와 문서 언어를 정하는 기준
처리할 페이지와 문서 언어는 OCR을 실행하기 전에 지정합니다. 3쪽 모두 이미지라면 1~3쪽을 선택하고, 본문이 한글 중심인 계약서라면 언어를 한국어로 맞춥니다.
일부 페이지만 검색되지 않는다면 전체 문서를 반복 처리하기보다 해당 페이지 범위를 지정합니다. 언어별 결과를 비교할 때는 같은 원본에서 만든 복사본 두 개에 동일한 페이지 범위를 적용해야 조건이 섞이지 않습니다.
OCR 언어 비교는 결과를 미리 가정하지 말고 같은 원본의 복사본 두 개에 같은 페이지 범위를 적용한 뒤, 이름·날짜·금액·주소·조항 5곳의 실제 복사 문자열로 선택을 결정합니다.
자료: Adobe Acrobat 도움말, 스캔한 문서에서 텍스트 인식, 2025년 11월 5일 갱신·2026년 8월 30일 확인
3쪽 예제로 OCR 문자열 5곳 기록하기
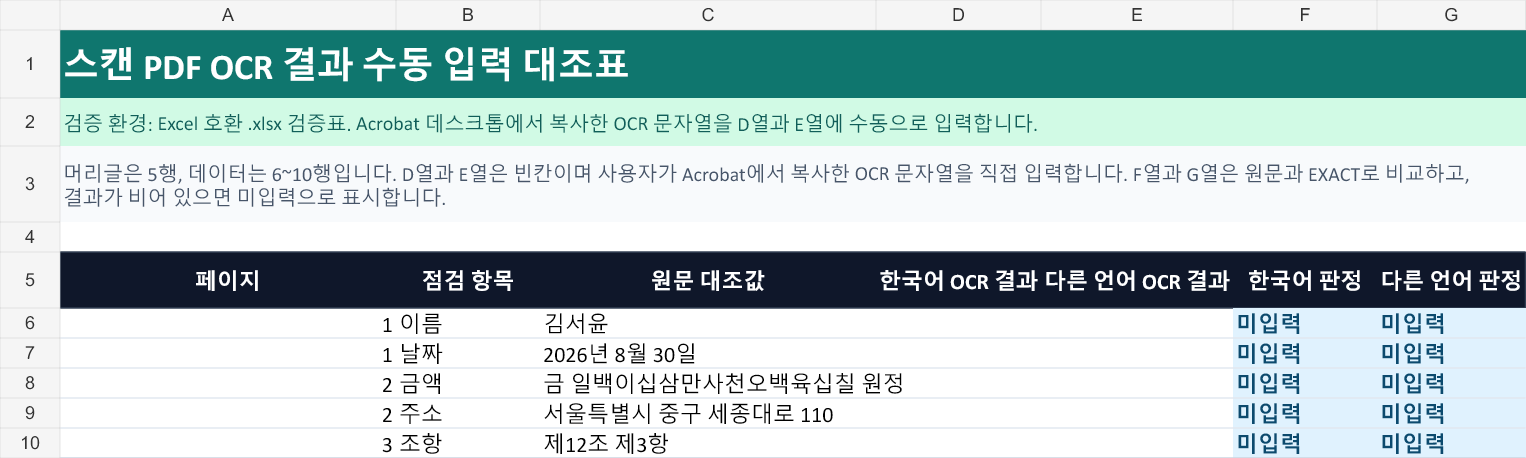
예제에는 아래 문구가 선명하게 인쇄된 3쪽 문서를 스캔해 사용합니다. 한국어 설정본과 비교 언어 설정본에서 같은 위치를 선택해 복사한 뒤 기록표의 D열과 E열에 붙여넣습니다.
| 데이터 행 | 페이지 | 점검 항목 | 원문 대조값 |
|---|---|---|---|
| 6행 | 1쪽 | 이름 | 김서윤 |
| 7행 | 1쪽 | 날짜 | 2026년 8월 30일 |
| 8행 | 2쪽 | 금액 | 금 일백이십삼만사천오백육십칠 원정 |
| 9행 | 2쪽 | 주소 | 서울특별시 중구 세종대로 110 |
| 10행 | 3쪽 | 조항 | 제12조 제3항 |
F6에는 =IF(D6="","미입력",IF(EXACT(C6,D6),"일치","불일치")), G6에는 =IF(E6="","미입력",IF(EXACT(C6,E6),"일치","불일치"))를 넣고 10행까지 복사합니다. 공백을 포함해 원문과 완전히 같을 때만 ‘일치’가 표시됩니다.
3쪽 예제의 원문 대조값과 판정 수식이 담긴 실습 파일입니다. OCR 결과 열은 비어 있으며 Acrobat에서 직접 복사한 문자열을 입력해야 판정됩니다.
처음 열었을 때 OCR 결과 열은 비어 있으므로 F6:G10에는 모두 ‘미입력’이 표시됩니다. 실제 복사 문자열을 입력한 뒤 ‘불일치’인 셀만 원본 이미지와 다시 대조하면 5곳을 빠뜨리지 않고 확인할 수 있습니다.
Acrobat에서 텍스트 레이어를 만드는 순서
Adobe의 Acrobat 데스크톱 도움말은 단일 문서에서 페이지 범위와 언어를 선택한 뒤 텍스트 인식을 실행하도록 안내합니다. 작업 전에는 복원 가능한 원본 복사본을 남겨 둡니다.
2026년 8월 30일에 확인한 Acrobat 데스크톱 한국어 도움말의 메뉴 명칭을 사용했습니다. 앱의 표시 언어나 제품 화면 구성에 따라 도구 위치가 다르게 보일 수 있습니다.
인식 오류와 복사 제한을 가려내는 법
OCR을 마치면 모든 도구 > 스캔 및 OCR > 인식된 텍스트 수정으로 이동합니다. 인식된 텍스트 검토를 켜면 Acrobat이 불확실하게 판단한 단어를 상자로 강조하며, 원본 이미지와 인식 문자열을 대조해 수정할 수 있습니다.
강조된 단어를 처리한 뒤에도 기록표의 5곳을 직접 복사해 확인하세요. 이름 한 글자, 금액의 숫자, 날짜의 공백처럼 업무상 중요한 문자는 별도 대조가 필요합니다.
문장을 선택할 수 있는데 복사 명령만 비활성화된다면 문서 작성자가 복사를 제한했을 수 있습니다. 이 경우에는 OCR을 반복하기 전에 문서 보안과 사용 권한을 확인합니다.
한국어 설정본과 다른 언어 설정본의 정확도가 반드시 특정 순서로 나온다고 가정하지 않습니다. D6:E10에 실제 문자열을 기록하고 F열과 G열의 일치 개수 및 오류 위치를 비교해 최종 설정을 판단합니다.
자료: Adobe Acrobat 도움말, 스캔한 PDF의 텍스트 인식 오류 수정, 2025년 11월 5일 갱신; PDF 내용 재사용, 2024년 12월 13일 갱신
검색·복사·원문 대조를 통과하면 완료
OCR 실행 메시지가 사라지거나 글자를 드래그할 수 있다는 사실만으로는 계약서 검수가 끝나지 않습니다. 검색 결과와 복사 문자열이 원문과 맞는지까지 확인하고 최종본을 저장합니다.
* 본문의 기능과 절차는 위 공식 문서와 3쪽 OCR 수동 대조 예제를 기준으로 구성했습니다. 공식 문서는 2026년 8월 30일에 열람했습니다.
'문서·PDF' 카테고리의 다른 글
| Adobe Acrobat에서 여러 PDF와 워드 파일을 순서대로 합쳐 한 파일로 만드는 법 (0) | 2026.09.04 |
|---|---|
| 워드 문서 비교로 변경 내용 추적 없이 수정된 부분 찾는 법 (0) | 2026.09.03 |
| Office 2021·LTSC 2021 지원 종료일과 업그레이드 판단 기준 (1) | 2026.09.02 |
| 워드 표지는 번호 없이 본문부터 1로 시작하는 구역별 페이지 번호 설정 (0) | 2026.09.01 |
| Adobe Acrobat Pro에서 PDF 개인정보 가림 처리와 숨은 정보 제거하는 법 (0) | 2026.08.31 |